START YOUR CAREER AT FURIOSA





ABOUT FURIOSA
Join us in making AI computing sustainable for everyone
Our mission is to make AI computing sustainable and so that everyone has accessible to powerful AI. We bring together the world’s best engineers to solve the most challenging computing problems and engineer the most impactful AI computing products. Join us on this ambitious and exciting journey.
Architecture
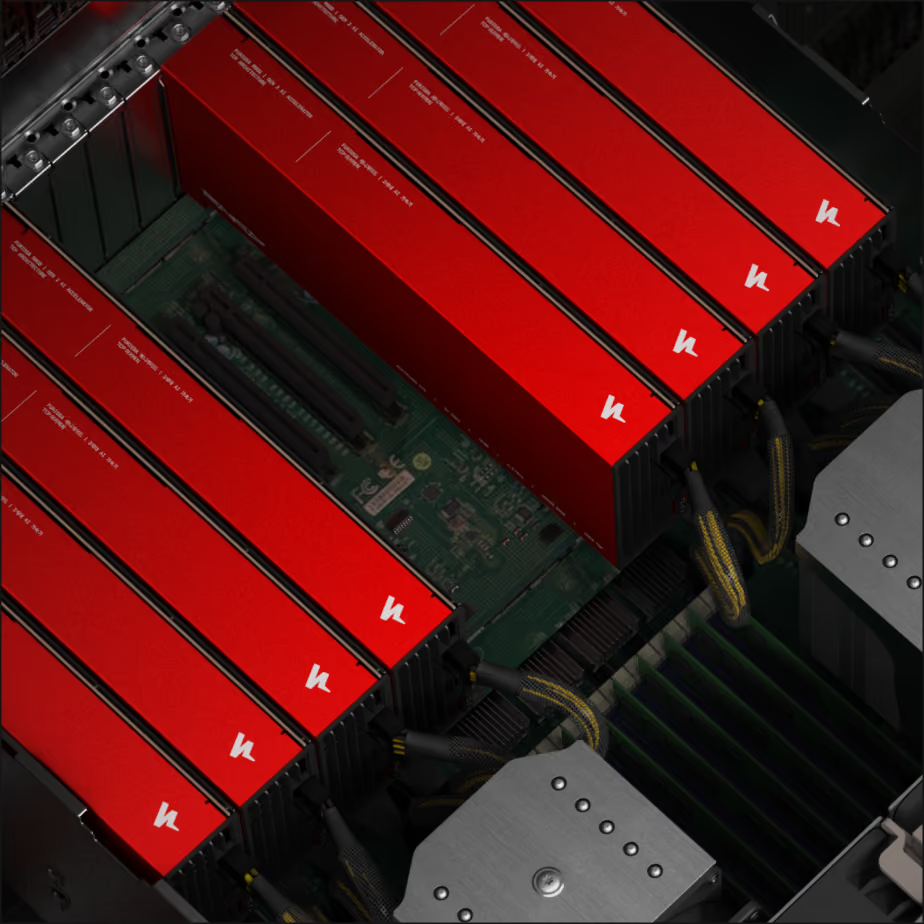
Furiosa RNGD PCIe
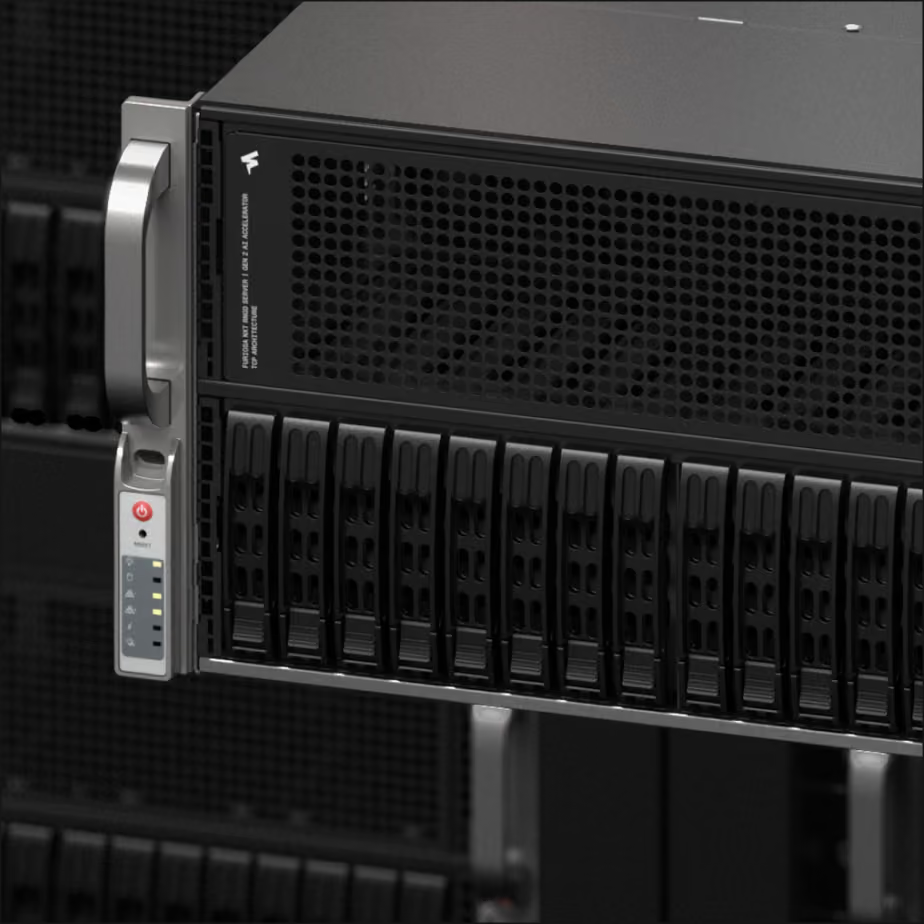
Furiosa NXT RNGD Server
OPEN ROLES
Hardware
Hardware팀은 AI 추론용 NPU의 Architecture 정의부터 RTL 설계, 칩 구현, 평가까지 칩 개발의 전 과정을 주도하는 조직입니다. 연산 엔진, On-Chip 네트워크(NoC), Chip 간 Interconnect 등 칩의 핵심 요소를 직접 정의하고 설계합니다.
1세대 Vision NPU와 2세대 RNGD의 성공적인 실리콘 양산 및 고객사 데이터센터 환경 검증을 마쳤으며, 이러한 두 차례의 Full-Cycle 개발 경험을 바탕으로 이론적 Architecture가 실제 칩의 결과물로 이어지는 설계 역량을 보유하고 있습니다.
현재 팀의 핵심 목표는 3세대 NPU 개발입니다. Latent MoE, Long-context attention, Linear attention/SSM 기반 Hybrid-Architecture, Multi-token prediction, 초저정밀 연산 등 1~2년 주기로 급변하는 AI 모델의 연산 패턴에 대응하기 위해 칩 구조를 지속적으로 재정의하고 있습니다. 시스템 성능의 기준이 단일 칩에서 랙(Rack) 단위로 확장됨에 따라, 최신 모델 구조를 분석하고 연산 병목(Compute-bound)을 파악하여 실리콘 면적 대비 효율을 극대화할 수 있는 하드웨어 설계를 도출하는 데 집중하고 있습니다.
시뮬레이션이나 FPGA 시연 결과로 끝나는 연구가 아닌, 아이디어가 실제 제품화되는 과정을 경험합니다. 새로운 연산 프리미티브 제안부터 워크로드 기반 성능 측정, 면적/전력 비용 분석, RTL 구현, 합성 및 타이밍 클로저, 최종 컴파일러 연동에 이르는 전과정을 경험할 수 있습니다. 자체 아키텍처, 최신 공정, Chiplet 구조, Rack-scale Interconnect가 적용된 대형 AI 가속기를 직접 설계합니다.
Hardware팀은 혁신과 새로운 기술에 열려 있습니다. Verilog 대신 Chisel을 이용한 설계, Cocotb Python을 이용한 검증 Flow, Rust로 자체 개발한 시뮬레이터 등, 개발 용이성과 우수성을 가졌다면 다양한 새로운 시도를 적극적으로 채택하고 활용합니다.
수평적인 조직문화로 팀 전체가 동일한 채널에서 분석하고 토론합니다. 연차에 상관없이 기술적 타당성만 있다면 분석 결과를 바탕으로 설계 방향에 대한 시사점을 제기하고, 실제 결정을 바꿀 수 있는 구조입니다.
[풀고자 하는 과제]
Scale-up Interconnect: 수십 개의 칩이 단일 가속기처럼 동작하도록 지원하는 표준 Ethernet 기반 Interconnect를 설계합니다. 대역폭과 Latency, 신뢰성, 링크 암호화 등을 설계하며 Rack Topology와 전력·냉각 아키텍처도 통합적으로 논의합니다.
Multi-die 및 최신 메모리 구조: Compute Die와 IO Die를 분리한 Chiplet 구조, 2nm/3nm 공정 노드, HBM4/4E를 도입합니다. Chip-to-Chip Interface 신뢰성, NoC 대역폭 최적화 및 Deadlock 방지, Fault-tolerant를 위한 설계 등 복잡도가 높은 과제들을 해결합니다.
설계 방법론 고도화: Chisel 기반의 RTL 생성, Rust 기반 자체 아키텍처 시뮬레이터 개발 및 Compiler 팀과의 협업, Formal Verification의 설계 파이프라인 통합 등 대규모 칩을 안정적이며 높은 완성도의 개발을 위한 인프라와 방법론을 구축합니다.
• 주요 업무:
◦ 최신 AI 모델 연산 분석을 통한 NPU Core 설계 및 RTL 개발
◦ 성능 모델 및 사이클 레벨 시뮬레이터 개발을 통한 면적·성능·정확도 트레이드오프 분석
◦ 컴파일러 팀과 긴밀히 협업하여 HW/SW 통합 실행 모델 설계
• 권장 기술: 컴퓨터 아키텍처, 성능 모델링 및 시뮬레이터 구현, RTL 개발, 딥러닝 모델 구조 분석
• 주요 업무:
◦ PE, CPU, 메모리 컨트롤러 통합 및 온칩 네트워크(NoC), AXI 인터커넥트 설계
◦ 전력/클록 도메인 분배, 대규모 SRAM 전략 수립 및 메모리 컴파일러 적용
◦ DFT/MBIST, RAS(신뢰성·가용성·정비성) 및 결함 허용(Fault handling) 아키텍처 구현
• 권장 기술: RTL 설계(Verilog/SystemVerilog, Chisel), NoC 및 버스 프로토콜
• 주요 업무:
◦ D2D(Die-to-Die), PCIe 및 자체 Scale-up 이더넷 인터커넥트 개발
◦ HBM4 Memory Controller 통합 및 최적화
◦ SI/PI 분석 및 Rack Scale 구조 설계, 시스템 신뢰성(BER/FIT) 확보
• 권장 기술: 고속 시리얼 인터페이스, 네트워크/통신 프로토콜, 신호처리, 오류 정정 및 신뢰성 분석
• 주요 업무:
◦ Spec 문서를 기반으로 검증 계획 수립 및 Python 또는 SystemVerilog/UVM 기반의 검증 환경 개발
◦ Directed 및 constrained-random test 개발과 regression 수행, hardware emulation 환경 구축 및 emulation 기반 검증
◦ Coverage closure 및 failure root cause 분석, 설계팀과의 협업을 통한 문제 해결과 corner case 및 잠재적 설계 오류 조기 발견
• 권장 기술: SystemVerilog/UVM, Formal Verification, Python
Compiler
FuriosaAI Compiler Team은 AI 모델이 FuriosaAI의 NPU에서 효율적으로 실행될 수 있도록 TCP(Tensor Contraction Processor) 아키텍처에 최적화된 컴파일러와 고성능 커널을 개발합니다.
PyTorch와 같은 AI 프레임워크의 모델을 컴파일러 내부 표현으로 변환하고, 그래프 및 텐서 프로그램 최적화부터 Operator Fusion, Tiling, Data Layout, Hardware Mapping, Scheduling 등 NPU 성능을 극대화하기 위한 다양한 문제를 해결합니다.
LLM, Multimodal, VLA 등 빠르게 변화하는 AI 워크로드를 지원하며, 실제 모델에서 발견한 문제를 재사용 가능한 커널과 범용적인 컴파일러 솔루션으로 발전시키는 데 집중합니다. 또한 자체 커널 프로그래밍 언어인 TCL(Tensor Contraction Language)과 관련 툴체인을 개발하고, AI 기술을 활용한 개발 생산성 향상도 탐구합니다.
Compiler Team에서는 아이디어가 코드가 되고, 실제 칩에서 동작하며, 제품 성능으로 이어지는 과정을 직접 경험할 수 있습니다. 컴파일러의 모든 영역을 알고 있을 필요는 없습니다. 복잡한 시스템의 원리를 이해하고 소프트웨어와 하드웨어의 경계를 넘나들며 문제를 해결하고 싶다면 함께해 주세요.
Platform
FuriosaAI Platform Team은 사용자가 RNGD를 효율적으로 활용할 수 있도록 저수준 소프트웨어 라이브러리부터 클러스터 규모의 분산 추론 시스템까지, RNGD 기반 소프트웨어 스택 전반을 개발합니다.
RNGD 칩의 PE(Processing Element)에서 동작하는 PERT와 호스트의 Device Runtime을 기반으로, 최신 LLM 워크로드를 처리하는 Furiosa-LLM 및 PyTorch 확장을 개발합니다. 나아가 대규모 Kubernetes 환경에서 RNGD의 스케줄링과 운영을 지원하는 Cloud Native 컴포넌트와 LLM Orchestration까지 담당합니다.
Platform Team은 하드웨어와 컴파일러, AI 모델 및 시스템에 대한 깊은 이해를 바탕으로 최신 AI 기술을 실제 제품에 구현합니다. 고객의 피드백을 직접 반영해 제품을 설계하고, 성능과 안정성을 개선하며, 자신이 개발한 소프트웨어가 실제 고객 환경에서 동작하는 과정을 경험할 수 있습니다.
Application
Application Team은 FuriosaAI 가속기에서 실제 AI 모델과 서비스가 동작하도록 커널과 애플리케이션을 개발합니다. FuriosaAI의 전체 스택에서 AI 모델의 요구사항을 커널, 애플리케이션, 서비스로 연결하는 영역을 담당합니다. 모델 실행, 커널, 서비스 API, 배포와 운영을 함께 고려해 가속기의 성능을 실제 사용자가 체감할 수 있는 결과로 만듭니다.
Application Team의 업무는 커널 개발·최적화와 AI 애플리케이션·서비스 개발로 나뉩니다.
Programming
Programming Team의 목표는 하드웨어 성능을 충분히 활용하면서도 커널과 애플리케이션 개발자가 사용할 수 있는 안정적이고 확장 가능한 프로그래밍 환경을 만드는 것입니다.
FuriosaAI의 전체 스택에서 하드웨어와 커널·애플리케이션 사이의 추상화 계층을 담당합니다.
가속기의 하드웨어 특성을 프로그래밍 모델, 실행 환경, 컴파일러·런타임 인터페이스와 개발 도구에 반영합니다.
병렬성, 메모리 계층, 데이터 이동과 실행 모델을 고려해 Virtual ISA(vISA)와 런타임 환경을 설계합니다.
AI Transformation
Furiosa AI 내부의 다양한 엔지니어링 문제들을 자율적으로 푸는 에이전트 시스템을 개발하고 있습니다.
NPU Kernel Optimization, Heuristic Algorithm Discovery 등 소프트웨어 영역에서의 최적화 문제, AI Chip 설계나 검증 등 하드웨어 영역에서의 문제들에 대한 범용적인 자율적 최적화 에이전트 시스템 개발
최적화 에이전트 시스템 스스로의 효율적인 탐색 능력을 개선하기 위한 Recursive Self-Improvement 시스템 개발
AI를 통해 엔지니어의 역할을 대체하려고 하는 것이 아닙니다. 엔지니어는 고차원적인 문제 정의와 평가 등에 집중하고 AI는 주어진 문제에 대한 빠르고 효율적인 솔루션 탐색을 수행하는 역할을 맡는 형태로 엔지니어링 과정 자체가 변화하고 있다고 생각합니다. 이런 관점에 부합하는 AI 시스템을 만들어 가고 있습니다.
AI Research
AI Research Team은 자체 LLM을 개발하고, 학습부터 추론과 agent에 이르는 전 영역에서 프론티어 연구를 수행하며 FuriosaAI를 프론티어 AI 회사로 만드는 팀입니다. Pre-training과 post-training을 통해 모델의 성능을 높이고, inference optimization과 agent 연구를 통해 모델이 복잡한 문제를 더 빠르고 안정적으로 해결할 수 있도록 합니다. 새로운 연구 아이디어를 대규모 환경에서 직접 검증하고, 그 성과를 실제 제품과 학계에 연결하는 것이 AI Research Team의 역할입니다.
Solution Architect
고객의 요구사항과 기술 과제를 분석해 적합한 솔루션을 제안하고, FuriosaAI NPU 기반의 AI 추론 환경을 구현하고 개선합니다. Furiosa SDK로 추론 프로그램과 데모를 개발하고, PoC와 성능 및 정확도 벤치마크를 수행하며 GPU 등 다른 환경과 비교합니다. 고객, 파트너, 개발자에게 제품의 기술적 특성과 활용 방법을 설명하고, 가이드와 교육을 통해 제품 도입과 활용을 지원합니다. 또한 현장의 요구사항과 피드백을 엔지니어링 팀과 공유하며 제품 개선에 기여합니다.
고객 요구사항 분석과 솔루션 제안부터 코드 작성, 성능과 정확도 검증까지 참여합니다. 직접 구현하고 실험하며 문제를 해결하고, 기술적 판단의 근거와 검증 결과를 명확히 설명해 고객의 의사결정을 돕습니다.
주니어와 시니어를 함께 모집하며, 경험과 역량에 따라 담당 범위와 책임 수준을 정합니다. 구체적인 과제는 온보딩 과정에서 개인의 역량과 팀의 목표를 고려해 함께 조율합니다.
